
Observatoires & Open Data
Les collectivités et administrations croulent sous les obligations de transparence. Loi pour une République numérique, directives européennes sur l’open data, demandes CADA qui s’accumulent : il faut publier des jeux de données toujours plus nombreux, toujours plus rapidement. Sauf que les équipes SIG et informatiques ont d’autres urgences. Les données sont éparpillées entre services, dans des formats hétérogènes : fichiers SIG propriétaires, exports Access vieillissants, tableaux Excel maintenus manuellement par des agents qui partent bientôt en retraite.
Et quand on parle de publier, la DSI freine : risques de fuite de données personnelles, serveurs déjà saturés, pas de budget pour une plateforme dédiée.
Résultat : des observatoires figés depuis 2019, des portails open data alimentés une fois par an lors des rapports d’activité, des citoyens et chercheurs qui réclament des données à jour. Pendant ce temps, les EPCI voisins publient leurs données sur data.gouv.fr et passent pour des modèles de transparence.
Cette solution appartient à la famille Données, Référentiels & Reporting.
Les défis qui freinent votre performance
La plupart des collectivités bricolent. Export CSV manuel depuis le SIG, anonymisation à la main dans Excel : un agent qui supprime des colonnes en espérant n’avoir rien oublié. Publication sur un serveur web basique ou envoi par mail aux demandeurs. Aucune traçabilité, aucune garantie de conformité RGPD.Les plateformes open data généralistes type CKAN ou OpenDataSoft demandent des compétences d’administration que les petites équipes n’ont pas. Quant aux prestataires historiques du secteur public, ils proposent des portails monolithiques facturés à l’année, rigides, qui deviennent vite des coquilles vides faute d’alimentation automatisée. Les données cartographiques restent coincées dans des PDF ou des images statiques, inexploitables pour qui voudrait les réutiliser.
Notre approche technique
Notre approche part d’un constat simple : les données existent déjà, elles sont juste mal exposées. On commence par cartographier les sources réelles : bases métiers, SIG, fichiers partagés : et on établit des flux d’extraction automatisés qui respectent les rythmes de mise à jour de chaque service. L’anonymisation n’est pas un filtre manuel mais un processus algorithmique configurable : agrégation géographique à la maille IRIS pour les données sensibles, suppression des identifiants directs, k-anonymat paramétrable selon la nature des jeux de données.
La diffusion passe par des API REST documentées qui permettent autant la consultation humaine via des interfaces cartographiques légères que l’intégration machine par des réutilisateurs. Les visualisations carto s’appuient sur des standards ouverts : WMS, WFS, GeoJSON : pas sur des formats propriétaires qui enferment. Chaque jeu de données publié est versionné, avec un historique accessible.
Services de diffusion documentés
Visualisation cartographique de données
Anonymisation algorithmique
Architecture technique
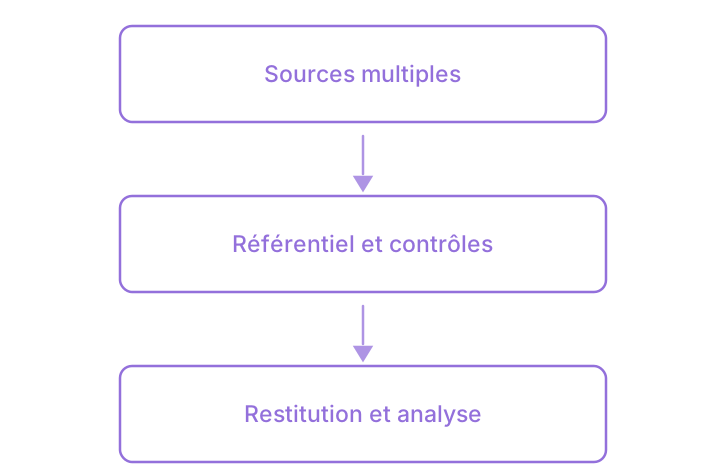
Plusieurs sources, un référentiel qui les arbitre, puis l’analyse : Traçabilité & Généalogie des Lots et Core RH & Référentiel Unifié procèdent de cette même chaîne.
- Services de diffusion documentés
- Visualisation cartographique de données
- Anonymisation algorithmique
Intégration fluide et sans friction
On ne remplace pas votre SIG ni votre infrastructure existante. Les connecteurs s’adaptent aux bases en place : PostGIS, votre base de données Spatial, fichiers Shape ou GeoPackage. Le portail de diffusion peut s’intégrer à votre site institutionnel existant ou fonctionner en autonome. Les flux alimentent aussi data.gouv.fr automatiquement si vous le souhaitez.
Pas de migration forcée, pas de formation de trois semaines : les agents continuent de travailler dans leurs outils habituels, la publication devient transparente.
Inventaire des sources et des obligations
Cartographie des données existantes, identification des jeux à publier en priorité selon vos obligations légales et les demandes récurrentes.
Configuration des flux et des règles d’anonymisation
Mise en place des connecteurs vers vos bases, définition des traitements d’anonymisation avec votre DPO, tests sur données réelles.
Déploiement du portail et des API
Installation de l’interface de consultation, des visualisations cartographiques et des services de diffusion documentés.
Autonomie et montée en charge
Formation des référents à l’ajout de nouveaux jeux de données, documentation des procédures, transfert progressif de la gestion quotidienne.
Des résultats mesurables pour l'organisation
- Délai de publication d’un nouveau jeu de données réduit de plusieurs semaines à moins de 48h
- 100% des données publiées passent par un processus d’anonymisation auditable
- Réduction de 80% des demandes CADA grâce à la mise à disposition proactive
- Conformité vérifiable aux obligations légales d’open data
- Taux de réutilisation des données multiplié par 3 à 5 selon les territoires
- Zéro incident de fuite de données personnelles sur les jeux publiés
Clarifier votre prise de décision
Comment garantissez-vous qu’aucune donnée personnelle ne fuite dans les publications ?
Chaque flux passe par des règles d’anonymisation définies avec votre délégué à la protection des données. Les techniques appliquées sont éprouvées, suppression, agrégation, k-anonymat, et un rapport d’audit accompagne chaque publication. Si une donnée sensible est détectée, la publication est bloquée automatiquement.
Nos agents n’ont pas le temps de gérer un outil de plus. Qui alimente le portail ?
L’alimentation du portail est automatisée depuis vos sources existantes : vos agents continuent leur travail dans leurs outils métier. Les flux sont configurés une fois, puis fonctionnent seuls. L’intervention humaine se limite à valider les nouveaux jeux de données avant première publication.